Google Cloud Run ja Firestore
- Google cloud run - hello world
- Kirjautuminen Googlen tunnuksella
- Firestore
- Flask-Caching
- Firestoren hierarkiat ja transaktiot
- Cloud runin instanssit ja kustannukset
- Appengine - vanha
- Google Datastore - vanha
- Lisätietoa
Siirretään sovelluksemme Googlen Cloud run -ympäristöön.
Huom. tehtävää ollaan päivittämässä cloudruniin eli jatkossa emme käytä enää appenginea. Sivun lopusta löytyy vielä vanhat appengine-ohjeet.
Ota ensimmäisenä käyttöön Googlen tarjoama tarjouskuponki, jolla voit kokeilla Googlen maksullisia pilvipalveluja antamatta oman luottokortin tietoja. Cloud runin peruskäyttö on ihan ilmaista, mutta esim. SQL-tietokannan käyttäminen maksaa.
Google cloud run - hello world
Kokeile yksinkertaisen flask-sovelluksen julkaisemista cloud runissa Googlen Quickstart: Build and deploy a Python (Flask) web app to Cloud Run -ohjeen avulla. Seuraavassa on selvennetty muutamaa kohtaa Googlen ohjeesta:
- Asenna ensimmäisenä gcloud cli. Asenna kansioon, jonka polussa ei ole välilyöntejä tai erikoismerkkejä eli älä asenna siihen polkuun, jota asennusohjelma windowsissa oletuksena ehdottaa. Asenna esim. c:\cloudsdk.
- Kannattaa käyttää Local shell eli tehdä määritykset oman koneen komentorivi-ikkunassa ( powershell tai WSL:n terminaali tms. )
- projektin id:na voit tässä käyttää esim. ties4080-ohjaus4
- Projektin sijainniksi kannattaa valita jokin lähellä oleva paikka kuten europe-north
- Ohjeessa mainitun cloud buildin vaaditut roolit saa määriteltyä Cloud buildin permissions -sivulla. Rooleja määritellessä pistä muistiin mille service accountille niitä määrittelet. Todnäk kyseisen service accountin osoite on muotoa 10101010-compute@developer.gserviceaccount.com. Tarvitset tätä osoitetta, kun myöhemmin suoritat googlen ohjeessa mainitun add-iam-policy-binding-komentorivikomennon.
Lisäksi on syytä asentaa Cloud Code -laajennos Visual Studio Codeen, jolloin pääset kehittämään ja testamaan sovellustasi myös lokaalisti omalla koneella Googlen pilviympäristöä vastaavassa docker-kontissa. Tämä ei onnistu yliopiston mikroluokkien koneilla, koska niille ei saa asennettua dockeria. Sovellusta voi kehittää myös flaskin omalla palvelimella, mutta lopullinen toimivuus on aina syytä varmistaa oikeassa ympäristössä.
- Install the Cloud Code for VS Code extension
- Kokeile ensimmäisenä saada yksinkertaisin hello world -sovellus toimimaan:
Quickstart: Build and deploy a Python (Flask) web app to Cloud Run
Lisää sovelluskansioosi .cloudignore-tiedosto ja lisää siihen seuraavat rivit:
.gcloudignore
.git
.gitignore
Lisätietoja sovelluksen julkaisemisesta Cloud runissa löytyy ohjeista Deploy to Cloud Run from source tai Deploy a Cloud Run service with Cloud Code for VS Code
Kirjautuminen Googlen tunnuksella
Google-tunnuksella kirjautuminen vaatii hieman esivalmisteluja, jotta saadan OAuth 2.0 toimimaan.
- Täytä ensimmäisenä OAuth consent screenin edellyttämät tiedot. Vain pakolliset tiedot tarvitsee täyttää.
- Seuraavaksi luo tarvittavat tunnisteet create credentials
- Valitse tyypiksi External. Internal toimisi vain yliopiston tunnuksilla
- Anna nimeksi esim. TIES4080 ohjaus4
- Google pyytää valitsemaan scopet. Valitse ainakin ..auth/userinfo.email. Jos Google ei näitä erikseen kysy, niin ne löytyvät myöhemmin Data Access -kohdasta.
- Siirry Credentials-sivulle ja valitse sieltä Create credentials ja vaihtoehdoista valitse OAuth client ID
- Valitse Application typeksi Web application
- Lisää Authorized JavaScript origins kohtaan palvelimesi osoite eli esim. http://localhost:8080/
- Lisää Authorized redirect URIs kohtaan ainakin:
http://localhost:8080/auth
http://127.0.0.1:8080/auth
Tämä on osoite jonne google ohjaa autentikoinnin jälkeen. Varmista, että portti (8080) on sama missä lokaali flask-palvelimesi toimii.Siirrettyäsi sovelluksen Googlen Cloud Run -palveluun, muista lisätä myös siellä oleva vastaava https-alkuinen osoite listaan.
Cloud runissa pitää lisäksi hieman kikkailla, koska Flaskin edessä pyörii Gunicorn, joka hieman hämää asioita Flaskilta ja estää autentikoinnin toimimisen suoraan salatun https-yhteyden kautta. Kts. mallikoodi google-login-cloud-run.zip, niin saat suojatun yhteyden toimimaan. Ilman tätä joudut käyttämään salaamatonta http-yhteyttä eikä se ole hyvä idea varsinkaan autentikoinnissa. Yleensä riittää seuraava lisäys Flask-soveluksen koodiin:
from werkzeug.middleware.proxy_fix import ProxyFix app.wsgi_app = ProxyFix(app.wsgi_app, x_for=1, x_proto=1, x_host=1, x_port=1) - Saat lopuksi Client ID ja Client secret -tunnisteet. Kopioi ne talteen.
- Valmis demosovellus löytyy osoitteesta https://github.com/authlib/demo-oauth-client/tree/master/flask-google-login.
Kopioi tai kloonaa valmis demosovellus omalle koneellesi.
- Asenna tarvittavat lisäkirjastot
- Kirjoita Googlelta saadut Client ID ja Client secret config.py-tiedostoon. Huom. ilman os.getenv-funktiokutsuja, jos et aseta kyseisiä tietoja ympäristömuuttujiin.
- Kokeile sovellusta ja kirjautumista
- Jos mallisovellus ei tunnu toimivan, kokeile käyttää autentikoinnin testaamiseen 'access_token' valmiissa sovelluksessa käytetyn 'userinfo' sijaan.
- Autentikoinnissa saamasi "user_info"-objekti on dict, joka sisältää
tarkempia tietoja kirjautuneestä käyttäjästä. Esim. käyttäjän sähköpostin
saa "email"-avaimella.
session['user'] = token['userinfo']
email = session['user']['email']
- signout (uloskirjautuminen eli käytännössä session tyhjentäminen) omasta sovelluksesta saattaa toimia hieman
hämmentävästi, koska googlen autentikointijärjestelmä helposti kirjaa käyttäjän heti takaisin sisään. Oman
sovelluksen signout ei siis kirjaa käyttäjää ulos googlen järjestelmistä eikä pidäkkään. Jos uloskirjautumisen
toiminta epäilyttää, niin kannattaa katsoa selaimen network-välilehdeltä mitä kaikkea uloskirjautumisen kohdalla
tapahtuu.
Jos haluat googlen tekevän uudelleen kirjautumiskyselyn, niin lisää "prompt:'consent'"-parametri:
Kts. Prompting re-consentoauth.register( name='google', server_metadata_url=CONF_URL, client_kwargs={ 'scope': 'openid email profile', 'prompt': 'consent' } )
Using OAuth 2.0 to Access Google APIs
Firestore
Varmista, että tietokoneellasi on uusin python. Mielellään Python 3.12.
Aloita ohjeen Get started with Cloud Firestore mukaan ja luo uusi firebase-projekti: Luo uusi firebase-projekti. Huom. Valitse ensimmäisenä linkki "Add Firebase to Google Cloud project" ja linkitä firebase-projektisi edellä luomaasi Google Cloud -projektiin.
- Firestore tarjoaa nykyään kaksi eri hinnoittelumallia: Blaze ja Spark. Koska sinulla on edellistehtävien jäljiltä käytössä billing account, niin google tyrkyttää väkisten Blaze-hinnoittelumallia. Hyväksy tämä. Voit myöhemmin projektin luomisen jälkeen vaihtaa malliksi Sparkin, joka ei turhaan kuluta billing accountin krediittejä.
- Luo uusi spark-hinnoittelumallin (ilmainen) projekti.
- Siirry Cloud Firestore-sivulle.
- Luo uusi Cloud Firestore -tietokanta. Tietokannan nimen on oltava default, jotta pystyt hyödyntämään Googlen tarjoamaa ilmaista quotaa. Firestore ilmaisen quotan käyttäminen ei vaadi billing accountin luomista / käyttämistä, kuten datastoren yhteydessä.
- Valitse Start in production mode.
- Valitse tietokannan sijainniksi Suomi tai jokin euroopassa sijaitseva palvelin
- Asenna virtuaaliympäristöösi firebase-admin ja google-auth
pip install --upgrade firebase-admin pip install --upgrade google-auth - Firestore täytyy vielä alustaa.
- Mene Service accounts-sivulle.
- Valitse edellä luomasi projekti.
- Valitse CREATE SERVICE ACCOUNT.
- Anna nimeksi esim. omakone.
- Valitse kohdassa Grant this service account access to project rooliksi Editor.
- Valitse edellä luomasi service accountin Actions-sarakkeesta Manage Keys
- Valitse ADD KEY ja Create new key
- Valitse avaimen tyypiksi JSON
- Tallenna avain projektisi kansioon omalle koneelle
- Luo uusi python-tiedosto alusta.py
-
Tutustu dokumenttiin Firestore Data model.
Liitä tiedostoon seuraava koodi:
import firebase_admin from firebase_admin import credentials from firebase_admin import firestore # Use a service account cred = credentials.Certificate('polku/tallentamaasi/json-tiedostoon/serviceAccount.json') firebase_admin.initialize_app(cred) db = firestore.client() #kokeile seuraavia doc_ref = db.collection('users').document('alovelace') doc_ref.set({ 'first': 'Ada', 'last': 'Lovelace', 'born': 1815 }) doc_ref = db.collection('users').document('aturing') doc_ref.set({ 'first': 'Alan', 'middle': 'Mathison', 'last': 'Turing', 'born': 1912 }) users_ref = db.collection('users') docs = users_ref.stream() for doc in docs: print(f'{doc.id} => {doc.to_dict()}') - Suorita alusta.py
python alusta.pyTarvittaessa asenna lisää kirjastoja kuten. google.auth.transport
-
Tutustu dokumenttiin Firestore Data model.
Liitä tiedostoon seuraava koodi:
- Nyt voit käyttää Firestorea esim. Flask-sovelluksessasi
- Firestore-sivulta pääset tutkimaan luomaasi Firestore-tietokantaa
Jos tietokantasi on jostain syystä mennyt datastore-moodiin, voit vaihtaa sen firestoren moodiin komennolla:
gcloud firestore databases update --type=firestore-native --database='(default)' - Tutustu Firebasen käyttämiseen Googlen firebase-tutoriaalin avulla:
- Add data to Cloud Firestore
- get data with Cloud Firestore
- Perform simple and compound queries in Cloud Firestore
- Order and limit data with Cloud Firestore
Flask-Caching
Onko sovelluksesi hidas? Kestääkö jokin laskenta kauan? Tehdäänkö samoja hitaita asioita usein uudelleen? Käytä välimuistia ja sovelluksesi nopeutuu. Käytätkö kallista pilvipalvelua, jossa prosessointiaika tai tietokantaoperaatiot maksavat? Käytä välimuistiä ja säästät kustannuksissa.
Flask-Caching-kirjastolla saa flask-sovellukseen helposti välimuistin.
- Asenna Flask-Caching
pip install Flask-Caching - Kirjoita testaamista varten jokin todella hidas funktio. Esim.
@app.route('/prime15000') def prime15000(): return prime(15000) @app.route('/prime/<int:n>') def prime(n): if n <= 1: return "[]" # hidas alkulukulaskenta-algoritmi # https://medium.com/@GalarnykMichael/prime-numbers-using-python-824ff4b3ea19 primes = [] for possiblePrime in range(2, n): isPrime = True for num in range(2, possiblePrime): if possiblePrime % num == 0: isPrime = False if isPrime: primes.append(possiblePrime) return str(primes) - Otetaan käyttöön välimuisti
from flask_caching import Cache config = { "DEBUG": True, "CACHE_TYPE": "SimpleCache", # välimuistin tyyppi "CACHE_DEFAULT_TIMEOUT": 60 #oletusaika välimuistille } app = Flask(__name__) app.config.from_mapping(config) cache = Cache(app) - Lisää edellä luomaasi prime15000-funktioon cache-dekoraattori seuraavalla tavalla:
Kokeile nyt latautuuko sivu nopeammin. Ensimmäisellä kerralla lataaminen kestää vielä kauan, mutta toisella kerralla sivun pitäisi latautua samantien. cache-dekoraattori pitää olla route-dekoraattorin jälkeen.@app.route('/prime15000') @cache.cached(timeout=50) def prime15000(): return prime(15000) - Voit cachettaa muitakin kuin flask-funktioita. Silloin täytyy
antaa dekoraattorille key_prefix-parametri, jota käytetään
välimuistin avaimena. Oletusavaimena toimii request.path eli välimuisti
toimii sivukohtaisesti.
@cache.cached(timeout=50, key_prefix='oma_tunniste') - Haluttaessa huomioida myös funktion eri parametrit välimuistissa käytetään
memoize-versiota:
Kokeile nyt erilaisilla luvuilla kutsua prime-funktiota. esim /prime/11000 ja /prime/15000.@app.route('/prime/<int:n>') @cache.memoize(timeout=50) def prime(n): ...Joskus on tarpeen hävittää välimuistista jokin tietty funktio. Kts. Deleting memoize cache.
- SimpleCache on yksinkertaisin versio välimuistista. Käytännössä se on vain palvelimen muistissa säilyvä dict. Esim. AppEnginessa tämä olisi instanssikohtainen välimuisti. Instanssin muistin määrä voi rajoittaa välimuistin kokoa. Käytettävissä on useita erilaisia välimuistityyppejä. Tiedostojärjestelmäversiota ei voi käyttää AppEnginella. Myöskään memcached-versio ei toimi AppEnginessa. Google tarjoaa Memorystore for Redis -välimuistin, mutta sen käyttäminen on maksullista. Kannattaa ensin kokeilla SimpleCachea, ja jos sillä ei pärjää, ostaa käyttöön RedisCachen. Googlen Redis on käytännöllinen vasta, jos sovelluksella on jatkuvasti (24/7) paljon käyttöä, koska Redis-instanssi on käynnissä koko ajan ja siitä joutuu maksamaan 24/7.
- Välimuistin käytössä täytyy miettiä tarkkaan mitä tietoja voi säilyttää välimuistissa ja missä tarvitaan aina tuoreita tietoja. Esim. reseptitietokantatyyppisessä sovelluksessa voisi välimuistia käyttää paljon ja pitkiä aikoja, koska reseptit muuttuvat hyvin harvoin eikä uusiakaan lisätä usein. Viikkotehtävissä käytetyssä tulospalvelutietokannassa tietojen täytyy päivittyä tiuhempaan, mutta esim. 30 sekunnin välimuistiviive tuloslistauksessa ei olisi vielä mikään ongelma. Tulospalvelutietokannassa esim. kilpailut ja sarjat muuttuvat harvoin eli näiden tietoja voisi hyvin säilyttää välimuistissa, mutta joukkueisiin liittyvät tiedot muuttuvat usein eikä niitä kannata välimuistittaa.
Firestore clients: To cache, or not to cache? (or both?)
Firestoren hierarkiat ja transaktiot
- Firestoressa voi luoda hierarkisia dokumenttikokoelmia. Hierarkisuus
on tarpeen vain jos on tarpeen käyttää transaktioita. Lue Transactions and batches writes.
Esim. jos sinulla on joukkue ja joukkueella on jäseniä, niin yleensä halutaan
muuttaa / päivittää samalla kerralla joukkueen ja sen jäsenten tiedot. Tässä
tapauksessa transaktiolle olisi tarvetta, JOS jäsenet ovat omana dokumenttinaan.
Vrt. aiemmin tehtyyn relaatiotietokantaan, jossa jäsenet oli tallennettu json-muodossa eikä silloin tarvittu jäsenille erillistä taulua. Jos jäsenet olisi laitettu erilliseen tauluun, tarvittaisiin relaatiotietokannassakin transaktiota joukkueen tietoja päivitettäessä. Jäsenten ollessa samassa tietueessa joukkueen muiden tietojen kanssa ei transaktiota tarvita.
Oletuksena voit käyttää firestorea kuten käytit aiemmin relaatiotietokantaa eli voit tehdä rakenteen relaatiotietokannan tapaan ja käyttää yhdistäviä avainkenttiä.
Luodaan malliksi hierarkinen reseptitietokanta, joka ei ehkä ole paras esimerkki, koska tämä toimisi paremmin ilman hierarkiaa.
ruokalajit = [
            {"id": 1, "nimi": "Alkuruoka", "reseptit": []},
            {"id": 2, "nimi": "Pääruoka", "reseptit": [
                {"nimi": "Ananas Con Carne", "kuvaus": "Tulinen", "henkilomaara": 4},
                {"nimi": "Banaanicurry", "kuvaus": "Mainio kasvisruoka", "henkilomaara": 2}
            ]},
            {"id": 3, "nimi": "Lisäkeruoka", "reseptit": []},
            {"id": 4, "nimi": "Väli- tai iltapala", "reseptit": []},
            {"id": 5, "nimi": "Jälkiruoka", "reseptit": []},
            {"id": 6, "nimi": "Suolainen leivonnainen", "reseptit": []},
            {"id": 7, "nimi": "Makea leivonnainen", "reseptit": [
                {"nimi": "Tiramisu", "kuvaus": "Hieno herkku", "henkilomaara": 6},
                {"nimi": "Porkkanapiirakka", "kuvaus": "Suuri herkku", "henkilomaara": 8},
                {"nimi": "Rommikakku", "kuvaus": "Hyytelökakku, ei tarvi paistaa", "henkilomaara": 6},
                {"nimi": "Kauralastut", "kuvaus": "Helppo ja nopea", "henkilomaara": 4}
            ]}
            ]

for ruokalaji in ruokalajit:
    #luodaan ruokalajit käyttäen omia tunnisteita (id)
   rlaji = db.collection('ruokalaji').document(str( ruokalaji["id"] ))
   rlaji.set({
       "nimi": ruokalaji["nimi"]
   })

   reseptit = ruokalaji["reseptit"]
   #luodaan reseptit automaattisilla tunnisteilla
#   for resepti in reseptit:
#       db.collection("ruokalaji", rlaji.id, "reseptit").document().set({
#          "nimi": resepti["nimi"],
#          "kuvaus": resepti["kuvaus"],
#          "henkilomaara": resepti["henkilomaara"]
#       })

   #annetaan resepteillekin oma id, että on helpompi testailla
   #huom eri ruokalajien alla olevilla resepteillä voi olla sama id!
   count = 1
   for resepti in reseptit:
       db.collection("ruokalaji", rlaji.id, "reseptit").document(str(count)).set({
          "nimi": resepti["nimi"],
          "kuvaus": resepti["kuvaus"],
          "henkilomaara": resepti["henkilomaara"]
       })
       count = count + 1
Kokeile valmiissa koodissa olevia eri tapoja luoda reseptit. Tutki miten ne ilmestyvät näkyviin Firestoren ylläpitonäkymään. Poista tuplaversiot samoista resepteistä ylläpitonäkymän kautta
- Aina ei ole käytettävissä valmista yksilöivää tietoa. Firestore osaa itse automaattisesti luoda
dokumentille uniikin id:n
>
#luo uuden dokumentin, joka on vielä tyhjä doc_ref = db.collection('tyyppi').document() #tunnisteen (id) saa suoraan id-ominaisuudesta id = doc_ref.id #dokumentin sisällön voi tallentaa set-metodilla doc_ref.set( omadata ) - Listaa kaikki ylätason kokoelmat:
collections_ref = db.collections() for col in collections_ref: documents = col.stream() for doc in documents: print(f'{doc.id} => {doc.to_dict()}') -
Mitäs jos halutaan listata kaikki reseptit? Tämä on hankalampaa, koska
jokainen resepti asuu yksittäisen ruokalajin reseptit-kokoelmassa.
Yksittäiseen ruokalajiin kuuluvat reseptit voi hakea seuraavalla
tavalla:
Kaikkien reseptien hakemiseen tarvitaan collection group -kysely:#haetaan kaikki jälkiruokareseptit. Jälkiruokalajin id on 7 reseptit = db.collection('ruokalaji/7/reseptit').stream() for resepti in reseptit: print(f'{resepti.id} => {resepti.to_dict()}')reseptit = db.collection_group('reseptit') docs = reseptit.stream() for doc in docs: print(f'{doc.id} => {doc.to_dict()}')Tämä ei kuitenkaan heti onnistu vaan ohjelma kaatuu virheeseen, jossa ilmoitetaan, että kysely tarvitsee tietynlaisen indeksin. Virheilmoituksessa saa suoraan kopioitua linkin, jonka avaamalla saa luotua tarvittavan indeksin.
"The query requires a COLLECTION_GROUP_ASC index for collection reseptit and field type. You can create it here: https://console.firebase.google.com/...Indeksin luominen kestää tovin. Jos yrität kyselyä uudelleen eikä indeksointi ole vielä valmista, saat uuden virheilmoituksen:
400 The query requires a COLLECTION_GROUP_ASC index for collection reseptit and field type. That index is not ready yet. See its status here: https://console.firebase.google.com... - Yritä listata reseptit ruokalajeittain seuraavalla tavalla:
Alkuruoka
Pääruoka
        Ananas Con Carne
        Banaanicurry
Lisäkeruoka
Väli- tai iltapala
Jälkiruoka
Suolainen leivonnainen
Makea leivonnainen
        Tiramisu
        Porkkanapiirakka
        Rommikakku
        Kauralastut
Malli
ruokalajit = db.collection('ruokalaji').stream() for ruokalaji in ruokalajit: print(f'{ruokalaji.to_dict()["nimi"]}') reseptit = db.collection('ruokalaji', ruokalaji.id, 'reseptit').stream() for resepti in reseptit: print(f'\t{resepti.to_dict()["nimi"]}') - Lisätietoa löytyy seuraavista : Admin SDK Reference ja google-cloud-firestore
Cloud runin instanssit ja kustannukset
Tämä käsittelee appenginea, mutta samat periaatteet pätevät cloud runiin. Cloud run -versio tulossa.
Cloud run luo tarpeen mukaan yhden tai useampia instansseja sovelluksestasi. Mitä enemmän sovelluksella on käyttäjiä/verkkoliikennettä tai mitä hitaammin sovellus vastaa pyyntöihin, sitä herkemmin Cloud run ottaa käyttöön useampia instansseja. Mitä enemmän instansseja on käytössä sitä nopeammin sovellus vastaa, mutta sitä enemmän sovellus myös kuluttaa palvelinresursseja ja google laskuttaa enemmän.
Cloud runin asetuksien säätämistä käsitellään dokumentissa Configure Cloud Run services
Asetuksia ei voi säätää jälkikäteen vaan asetusten muuttaminen tapahtuu aina luomalla sovelluksesta uusi revisio "Edit & deploy new revision". Oletuksena uusi revisio ottaa haltuunsa sovelluksen liikenteen. Vanha revisio kannattaa säilyttää jonkin aikaa, jos uudessa onkin bugeja, ja haluaa siirtää sovelluksen toiminnan vanhalle versiolle.
Tärkeimmät asetukset:
- Web-sovelluksesta tulee yleensä julkinen (Allow public access)
- Hinnoittelumalleja on kaksi: request-based ja instance-based. Tyypillisesti pieni web-sovellus on halvinta request-based-hinnoittelulla eli laskua kertyy vain ja ainoastaan silloin, kun sovellus käsittelee webistä saapuvaa pyyntöä. instance-based-versiossa taas on suuremmat kiinteät kulut, mutta tämä voi käydä halvemmaksi, jos sovelluksella on paljon jatkuvaa käyttöä ja liikennettä.
-
Palvelun skaalauksessa voi määritellä montako instanssia sovelluksesta
on vähintään tai enintään käytössä. Minimiksi on hyvä laittaa 0 eli sovellus
sammutetaan kokonaan, jos käyttöä ei ole. Sivupyynnön tullessa sovellusinstanssi
käynnistetään ja se voi kestää ensimmäisellä pyynnöllä tovin. Tyypillisesti
instanssia ei sammuteta heti vaan se pysyy jonkin aikaa päällä ja palvelee
seuraavat pyynnöt nopeasti.
Jos kuormitusta on paljon, cloud run käynnistää automaattisesti lisää instansseja palvelemaan liikennettä. Näille voi määrittää maksimin ja kannattaakin määritellä, koska tämä estää kustannuksia hyppäämästä pilviin, jos käyttäjiä tuleekin yhtäkkiä hirvittävän paljon.
- Resursseissa voi asettaa instanssin maksimimuistin ja prosessorien lukumäärän. Nämä kannattaa oletuksena pitää minimeissä (128 MiB ja 1). Vasta jos huomaa, että tarvii oikeasti lisää muistia tai prosessointitehoa, kannattaa näitä kasvattaa. Mitä enemmän muistia ja prosessoreita instanssi tarvitsee, sitä enemmän Google laskuttaa käytöstä.
- Requests-kohdassa voi määritellä palvelimen aikakatkaisurajan. Oletuksena oleva 300 sekuntia on aivan hyvä. Samoin oletuksena oleva samanaikaisten pyyntöjen (concurrent requests) määrä on ihan hyvä, mutta voi mahdollisesti olla paljon suurempikin. Jos Flaskin sijaan toteuttaa sovelluksensa esim. asynkronisella Quartilla, voi tätä arvoa pystyä paljonkin suurentamaan. Mitä suurempi arvo, sitä helpommin Google antaa yhden instanssin palvella ennen uuden instanssin käynnistämistä.
- Suoritusympäristöksi (execution environment) kannattaa oletuksena valita "First generation", joka sallii asettaa käytetyn muistin määräksi jopa vain 128 Mib. Tämä voi hyvinkin riittää pienissä sovelluksessa ja alentaa käyttökuluja.
- Jos instanssin kylmäkäynnistys tuntuu liian hitaalta voi "Startup CPU boost" auttaa
Cloud run -sovelluksen kustannuksiin vaikuttaa myös firestore: mitä enemmän dataa tallennat sitä enemmän google laskuttaa. Käytännössä eniten vaikuttaa kuitenkin dataliikenne eikä tallennetun datan määrä. Ts. jokaisen yksittäisen tietueen (entity) lukeminen firestoresta maksaa ja samoin myös tietueen kirjoittaminen firestoreen maksaa. Google tarjoaa kuitenkin hyvän ilmaisen (free tier) quotan, jonka puitteissa pystyy jo tekemään isohkojakin sovelluksia maksamatta senttiäkään. Ilmainen quota on laskutustilikohtainen. Kts. Firestore pricing Kustannuksien säästämiseksi google tarjoaa maksullisia välimuistipalveluja kuten Memorystore. Emme kuitenkaan käytä näitä nyt tällä kurssilla. Flask tarjoaa oman yksinkertaisen välimuistin, joka voi jo auttaa paljon.
Appenginen skaalaus - vanha
App Enginen skaalausta ja muita ominaisuuksia voi säätää app.yaml-tiedoston avulla.
runtime: python312  #python-tulkin versio

default_expiration: "24h"  #määrää staattisten tiedostojen säilymisiän välimuistissa
instance_class: F1 #käytetyn instanssin teholuokka. F1 on heppoisin ja halvin
                   #älä käytä tällä kurssilla tehokkaampia

automatic_scaling:
  target_cpu_utilization: 0.65  #raja-arvo, jonka jälkeen käynnistetään uusia instansseja
  min_instances: 2 #instanssien minimimäärä. 0 tarkoittaa, että instanssit voidaan kaikki sammuttaa, jos sovelluksella ei ole käyttöä
                   #sovelluksen käynnistyminen on hitaampaa, jos kaikki instanssit ovat pois päältä
                   #Käytä tällä kurssilla arvoa 2 eli koko ajan on käytössä kaksi instanssia
                   #tällä määrällä saa hyvin testattua toimiiko sovellus kunnolla useamman instanssin tapauksessa
                   #huom. kaksi koko ajan käynnissä olevaa instanssia vie paljon rahaa. Aseta instanssien nimimimääräksi
                   #0 silloin kun et sovellusta tarvi
                   #varo globaaleja muuttuja, koska ne ovat instanssikohtaisia
  max_instances: 1   #instanssien maksimimäärä. Mitä suurempi lukumäärä sitä suuremmat mahdolliset kustannukset
  min_idle_instances: 0 #jouten olevien instanssien minimimäärä
  max_idle_instances: 1 #jouten olevien instanssien maksimimäärä
  min_pending_latency: 30ms #kauanko odotetaan jonossa ennen kuin luodaan uusi instanssi
  max_pending_latency: 100ms #jos odotusaika on minimin ja maksimin välissä yritetään käyttää olemassa olevaa instanssia
  max_concurrent_requests: 50 #montako yhtäaikaista pyyntöä yksi instanssi kelpuuttaa ennen kuin luodaan uusia instansseja
Tarkemmat tiedot asetuksista löytyvät app.yaml referencestä
Appengine - vanha
Appengine on googlen vanhempi alusta web-sovelluksille. Suositeltavampaa
on käyttää uudempaa cloud runia. Tämä ohje on tässä vielä jäljellä kaiken
varalta, mutta ei ole siis olennainen enää 2026 alkaen.
Siirretään sovelluksemme Googlen App Engine -ympäristöön. App Engine tarjoaa kaksi ympäristövaihtoehtoa: standardiympäristön ja joustavan ympäristön. Käytämme standardiympäristöä, joka on yksinkertaisin ylläpitää ja pienille sovelluksille myös edullisin.
- Luo uusi App Engine projekti
-
Käytä projektin nimenä ja id:nä esim. ties4080-ohjaus4.
Valitse Billing Accountiksi edellä aktivoimasi kuponki. Jos Billing Account
-valintaa ei näy ollenkaan niin älä huolestu. Google valitsee automaattisesti
ainoan mahdollisen eli edellä luodun kupongin.
Valitse organisaatioksi student.jyu.fi tai No Organization.
Google muuttaa käyttöliittymää vähän väliä, mutta älä anna sen hämätä.
Lisätietoa: Managing Cloud Platform Projects, App Engine Applications, and Billing .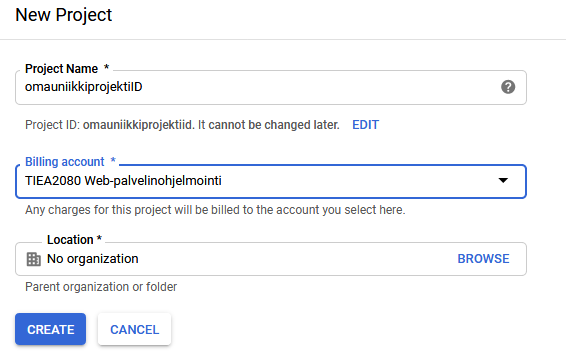
-
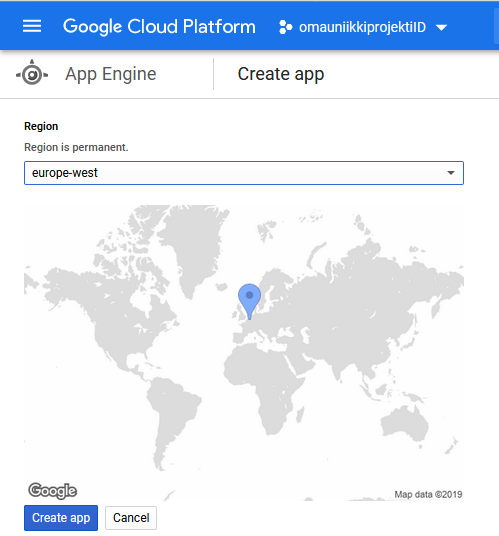
Jos mahdollista, niin valitse projektin sijoituspaikaksi Suomi tai Suomea lähellä oleva vaihtoehto (europe-east, europe-west tms).
- Valitse sovelluksen kieleksi Python ja ympäristöksi Standard.
- Seuraavat asiat kannattaa tehdä Windowsiin asennetulla linuxilla( WSL, Windows Subsystem for Linux),
koska appenginen Python 3 -sovellusten testaaminen ei tällä hetkellä onnistu puhtaassa windows-ympäristössä.
Asenna koneellesi WSL ja ubuntu
Vaihtoehto: kehitä ja testaa suoraan googlen pilvessä (hitaampi)
Jos et halua/pysty asentamaan tarvittavia ympäristöjä omalle koneellesi, voit käyttää myös Cloud Shell-ympäristöä selaimella. Cloud shellissa voit suoraan ajaa gcloud-komentoja. Tee vaadittavat alkuasennukset (gcloud-komennot) samaan tapaan kuin linux-versiossa. Kts. Deploy an App Engine app by using Cloud Shell . ja How to deploy your web app to Google Cloud via GitHub.Lue myös Deploying to App Engine with Cloud Build, jos haluat automaattisen deployn toimivan suoraan versionhallinnastasi. Ohjeen määräämän App Engine Admin -roolin lisäksi täytyy myös Service Accounts -kohta asettaa enabloiduksi.
- Toimi ohjeen https://cloud.google.com/sdk/docs/install-sdk mukaan ja
asenna Cloud SDK omalle koneellesi. Asenna myös App Enginen vaatimat lisäosat. Kts. Managing SDK Components
tai vaihtoehtoisestisudo apt-get install google-cloud-cli google-cloud-cli-app-engine-java google-cloud-cli-app-engine-python google-cloud-cli-app-engine-python-extras google-cloud-cli-datastore-emulatorgcloud components install app-engine-pythongcloud components install app-engine-python-extrasgcloud components install cloud-datastore-emulatorgcloud components install cloud-firestore-emulatorgcloud components install cloud-firestore-emulator
Asenna myös uusin Python:
sudo apt update
sudo apt install python3 python3-dev python3-venv python-pip virtualenv
WSL-istunnon (linux) kotihakemisto (home directory) näkyy myös windows-puolelle. Oikean polun löydät helpoiten kirjoittamalla linuxin komentoriville:
joka avaa windowsin tiedostojen hallinnan oikeasta kansiosta.explorer.exe . -
Katso ohjeesta Writing a Basic Web Service for App Engine malli ja kokeile tehdä oma pieni sovellus.
Ota käyttöösi ohjeessa annettu valmis Hello World -sovellus. Kts. hello_world. Muistithan edellä luoda appenginen standard-version? Flexible-versio syö nopeasti kuponkisi rahat, joten älä käytä sitä.Varmista, että olet kirjautuneena googlen palveluun ja oikeaan projektiin:
Testaa sovellusta ohjeen mukaan omalla koneellasi.gcloud auth login
--python_virtualenv_path-parametri nopeuttaa dev_appserverin uudelleen käynnistämistä käyttämällä samaa virtualenvia uudelleen. Local development server options. Huom. jos sovelluksesi käyttää muita kuin aivan vakiokirjastoja, on kaikki tarvittavat kirjastot lueteltava requirements.txt-tiedostossa. Lisätietoa: Specifying dependencies. Kokeile myös julkaista (deploy) sovelluksesi pilvessä.python3 /usr/bin/dev_appserver.py app.yaml --python_virtualenv_path=venvgcloud app deployTarkempia lisäohjeita voi tarvittaessa lukea dokumentista: Building a Python 3 App on App Engine
Sovellusta julkaistaessa (deploy) täytyy muistaa komentorivillä kertoa mihin projektiin ja mikä versio ollaan julkaisemassa. Jos versiota ei anneta, luo gcloud-komento aina uuden version.
(env) PS D:\appengine> gcloud app deploy --project ties4080-ohjaus4 --version 1 Services to deploy: descriptor: [D:\appengine\app.yaml] source: [D:\appengine] target project: [ties4080-ohjaus4] target service: [default] target version: [1] target url: [https://ties4080-ohjaus4.oa.r.appspot.com] Do you want to continue (Y/n)? Y Beginning deployment of service [default]... Created .gcloudignore file. See `gcloud topic gcloudignore` for details. #============================================================# #= Uploading 14 files to Google Cloud Storage =# #============================================================# File upload done. Updating service [default]...done. Setting traffic split for service [default]...done. Deployed service [default] to [https://ties4080-ohjaus4.oa.r.appspot.com] You can stream logs from the command line by running: $ gcloud app logs tail -s default To view your application in the web browser run: $ gcloud app browse --project=ties4080-ohjaus4 -
Oletuksena uusi sovelluksen versio ottaa haltuunsa kaiken sovelluksen liikenteen. Jos et halua näin tapahtuvan, lisää komentoriville parametri --no-promote. Kts. gcloud app deploy. Sovelluksen eri versioiden tiedot ja linkit niihin löytyvät Versions-sivulta.
Sovelluksesta jää helposti käyntiin useita turhiakin versioita. Poista turhat versiot, koska ne aiheuttavat turhaan kustannuksia erityisesti silloin, jos niissä on jatkuvasti instansseja käynnissä. Poistaminen onnistuu helposti Versions-sivulla. Samalla sivulla voi myös siirtää liikenteen jollekin halutulle sovelluksen versiolle tai jakaa liikenteen useamman version kesken.
- Kokeile sovellustasi osoitteessa https://oma_tunniste.appspot.com
- Sovelluksesi resursseja ja muita tietoja voit silmäillä App Enginen ylläpitosivun kautta. Esim. jos sovelluksesi kaatuu, niin voit ylläpitosivun kautta etsiä Error Reporting-sivulta kaatumisen aiheuttaneen virheen. Sovelluksen päivittäminen pilveen ei kopioi lokaalin tietokannan sisältöä.
- Lue seuraavat Googlen ohjeet:
- Lisätietoa löytyy Googlen ohjeesta Getting Started with Flask on App Engine Standard Environment
Google
Datastore - vanha
Datastore on vanhempi googlen NoSQL-tietokanta. Pyrimme käyttämään
jatkossa Firestorea (native mode).
Googlen Datastore on NoSQL-tietokanta. Datastorea voi käyttää melkein samaan tapaan kuin relaatiotietokantoja.
Liitoksia ei voi käyttää Datastoren kyselyissä.
Uusin versio Datastoresta on rakennettu Googlen Firestore tietokannan päälle. Firestorea voi käyttää joko natiivimoodissa tai Datastore-moodissa. Käytämme Datastore-moodia.
Choosing between Native mode and Datastore mode.
- Luo uusi tietokanta Datastore-moodissa
- Määrittele autentikointiavain ja lataa se omalle koneelle:
- Luo ensin uusi service account, jolle määrittelet rooliksi projektin omistaja (Project -> Owner)
- Lisää edellä luodulle tilille uusi avain (key). Tallenna saamasi avain (json-tiedosto) koneellesi.
-
Luo uusi tiedosto esim. setenv.bash ja lisää sinne seuraava rivi, jossa korvaat KEY-kohdan
polulla edellä saamaasi json-tiedostoon. Seuraava toimii linuxilla (ubuntussa) bash-shellillä:
suorita edellä tekemäsi skripti:export GOOGLE_APPLICATION_CREDENTIALS="/foo/bar/polku/JSON-tiedosto.json" export FLASK_APP="main.py" export FLASK_ENV="development" export GOOGLE_CLOUD_PROJECT="oman projektin id"source setenv.bashpowershell-versio
Luo uusi tiedosto set_vars.ps1 ja lisää sinne seuraava rivi, jossa korvaat KEY_PATH polulla edellä saamaasi avaimeen (JSON-tiedosto)
Suorita set_vars.ps1-tiedosto powershell-komentoriviltä.$env:GOOGLE_APPLICATION_CREDENTIALS="/foo/bar/polku/json-tiedostoon"
Edellämainittu asettaa tarvittavat ympäristömuuttujat.C:\MyTemp\TIES4080\ohjaus4> .\set_vars.ps1cmd-versio
Jos käytätkin cmd-promptia, niin tarvitset set_vars.cmd-tiedoston:
set FLASK_APP="main.py"
set FLASK_ENV="development"
set GOOGLE_APPLICATION_CREDENTIALS="C:\mytemp\ties4080\ohjaus4\ties4080-ohjaus4-3b2815e4f4f1.json"
-
Lisää hello world -sovelluksen requirements.txt-tiedostoon rivi:
ja suorita uudelleengoogle.cloud.datastore
Kaikki tarvittavat kirjastot täytyy aina lisätä requirements.txt-tiedostoon. Google asentaa tämän tiedoston perusteella tarvittavat kirjastot myös app engine -palvelimeesi.pip install -r requirements.txtKokeile nyt Datastorea lisäämällä hello world -ohjelmaasi uusi sivu:
Key yksilöi jokaisen datastoreen tallennetun objektin. Jonkun tietyn objektin voi aina pyytää datastoresta Keyn avulla (key.get()).import google.cloud.datastore @app.route('/data') def datatesti(): datastore_client = google.cloud.datastore.Client() # Tallennettava tyyppi kind = "Testi" # id/nimi name = "mallitietue1" # Datastoren avain lisättävälle objektille testi_key = datastore_client.key(kind, name) # Varsinaisen objektin luominen testi = google.cloud.datastore.Entity(key=testi_key) testi["kuvaus"] = "Testiteksti" # Saves the entity datastore_client.put(testi) return f"Tallennettiin {testi.key.name}: {testi['kuvaus']}" - Tutki mitä datastoreen tallentui
- Kokeile
Datastore-emulaattoria. Emulaattori toimii omalla koneellasi ja voit sillä
kokeilla, testata ja kehittää ilman, että vahingossa sotket pilvessä olevaa
tietokantaa.
Kts.Googlen ohje Setting environment variables
Emulaattorin saa tulostamaan ympäristömuuttujat komennolla
gcloud beta emulators datastore env-init- Emulaattori tarvitsee toimiakseen Java JREn. Esim. JDK 22 tai uudempi. Muista lisätä java järjestelmän polkuun. Javan asentaminen WSL-ympäristöön.
- Oletuksena emulaattori on vain eventually consistent, joka vastaa
vanhan datastoren toimintaa. Nykyinen Firestorella toimiva Datastore on kuitenkin
strongly consistent. Käynnistä emulaattori seuraavalla tavalla niin se
toimii pilviversiota vastaavalla tavalla:
gcloud beta emulators datastore start --use-firestore-in-datastore-mode - Emulaattorin tietokannan tallennuspolun voi määritellä parametrilla --data-dir. Seuraava
luo tietokannan oletuskansioon:
gcloud beta emulators datastore startgcloud beta emulators datastore start --consistency=1.0 --data-dir=.\ - Parametrilla --no-store-on-disk saa emulaattorin toimimaan vain muistissa. Mitään ei tallenneta levylle. Emulaattorin tallentaman datan saa poistettua sammuttamalla emulaattorin ja poistamalla sen jälkeen tiedoston /WEB-INF/appengine-generated/local_db.bin-tiedoston.
- Emulaattorin datastoreen tallentuneita tietoja voi selata osoitteesta: http://localhost:8000/datastore
- Tutustu dokumenttiin Entities, Properties, and Keys
- Datastoren entiteeteistä voi muodostaa hierarkisia rakenteita. Kts. Ancestor
paths. Käytännössä hierarkisia rakenteita ei tarvitse rakentaa ellet tiedä tarvitsevasi
transaktioita.
Reseptitietokanta on malliesimerkki hierarkiasta. Seuraavassa rakennetaan datastoreen hierarkinen reseptitietokanta. Tämä ei ole kuitenkaan millään tavalla välttämätöntä vaan voit rakentaa samanlaisen reseptitietokannan myös ilman hierarkiaa. Huolehdit vain, että eri entiteettien välille on olemassa relaatiotietokannan tapaan yhdistävä kenttä. Relaatiotietokannan rakennetta ei yleensä kannata suoraan kopioida datastoreen, vaan voit rikkoa tarvittaessa normaalimuotoja.
Jokainen resepti on tiettyä ruokalajia. Ruokalaji on Datastoren kannalta ns. root entity. Resepti on aina jonkun Ruokalajin lapsi (child). Yksi ruokalaji toimii aina kunkin reseptin vanhemapna (parent).
Lisää edellisen mallin mukaan seuraavasta rakenteesta tietokannan ruokalajit ja reseptit Datastoressa olevaan tietokantaasi. Lisää flask-sovellukseen uusi sivu, jolla voit tehdä lisäämisen. Tarkista Datastoresta, että kaikki meni oikein. Datastore listaa aina vain tietyn tyyppiset entiteetit. Jos lisäämääsi ei näy listassa, tarkista, että sivulla annettu kind on oikea. Tarvittaessa poista epäonnistuneet tai vääränlaiset entiteetit.client = google.cloud.datastore.Client() vanhempikey = client.key("Vanhempi", "123") #id täytyy antaa, että voidaan käyttää parentina vanhempi_entity = datastore.Entity(key=vanhempikey) vanhempi_entity.update( { "nimi" : "testiobjekti", "kuvaus": "tämä on root" } ) lapsikey = client.key("Lapsi", parent=vanhempikey) # datastore keksii itse id:n lapsi_entity = datastore.Entity(key=lapsikey) lapsi_entity.update ({"nimi": "Lapsi", "kuvaus": "olen lapsiobjekti", "omin1": "..."} ) client.put_multi( [vanhempi_entity, lapsi_entity] ) #put_multi-metodilla voidaan tallentaa useampi kerralla. Nopeaa ja säästää kuluissa
Muista, että kaikki luku- ja kirjoitusoperaatiot pilvessä olevaan datastoreen maksavat. Ilmaisella kapasiteetilla saa tehtyä jo aika paljon. Jos reseptitietokantaan lisättäisiin esim. reseptikohtaisia ainemääriä ja reseptin teko-ohjeita, niin ne kannattaisi kaikki tallentaa reseptientiteetin yhteyteen. Relaatiotietokannassa näitä varten luotaisiin omat taulut, mutta datastoressa vastaava nostaisi merkittävästi kustannuksia, koska jokaisen entiteetin lukeminen ja kirjoittaminen maksaa erikseen. Datan eheyden ylläpitäminen jää datastoressa enemmän ohjelmoijan vastuulle. Jos joudut käsittelemään suuriä tietomääriä, kannattaa ensin harjoitella lokaalilla datastore emulaattorilla.ruokalajit = [ {"nimi": "Alkuruoka", "reseptit": []}, {"nimi": "Pääruoka", "reseptit": [ {"nimi": "Ananas Con Carne", "kuvaus": "Tulinen", "henkilomaara": 4}, {"nimi": "Banaanicurry", "kuvaus": "Mainio kasvisruoka", "henkilomaara": 2} ]}, {"nimi": "Lisäkeruoka", "reseptit": []}, {"nimi": "Väli- tai iltapala", "reseptit": []}, {"nimi": "Jälkiruoka", "reseptit": []}, {"nimi": "Suolainen leivonnainen", "reseptit": []}, {"nimi": "Makea leivonnainen", "reseptit": [ {"nimi": "Tiramisu", "kuvaus": "Hieno herkku", "henkilomaara": 6}, {"nimi": "Porkkanapiirakka", "kuvaus": "Suuri herkku", "henkilomaara": 8}, {"nimi": "Rommikakku", "kuvaus": "Hyytelökakku, ei tarvi paistaa", "henkilomaara": 6}, {"nimi": "Kauralastut", "kuvaus": "Helppo ja nopea", "henkilomaara": 4} ]} ]
Lisätietoa
- Using Cloud Firestore in Datastore Mode
- google-cloud-datastore
- Datastore Entity
- Transaktiot Datastoressa
Kyselyt (Datastore Queries) - vanha
Käytä Firestore (native mode). Tässä vielä vanha datastoreohje kaiken varalta.- Yksinkertaisin kysely on pyytää entiteettiä sen keyn perusteella:
key = client.key('tyyppi', 1234) client.get(key) - Key ei kuitenkaan ole aina tiedossa vaan täytyy pyytää entiteettejä niiden
tyypin perusteella:
tuloksena on lista entiteeteistä, joiden ominaisuuksiin pääsee käsiksi kuten dicteissä.query = client.query(kind="Ruokalaji") results = list( query.fetch() )
Lisää ohjelmaasi sivu, jossa haet datastoresta kaikki reseptit ja listaat sivulle niiden nimet ja henkilömäärät Entiteetiltä voi pyytää myös sen keyn, jonka kautta pääsee käsiksi myös sen mahdollisen parentin avaimeen. esim.for r in results: print( r["nimi"] )
Entiteettien hierarkiaa voi hyödyntää ancestor-kyselyissä, joissa haetaan kaikki tiettyyn vanhempaan (ancestor) liitetyt entiteetit:results = list( query.fetch() ) for r in results: print( r.key ) # entiteetin avain (key) print( r.key.id ) #entiteetin id (kokonaisluku ) print( r.key.parent ) #entiteetin mahdollisen parentin key print( r.key.parent.id ) #mahdollisen parentin idvanhempi = client.key("Ruokalaji", 1) query = client.query(kind="Resepti", ancestor=vanhempi) - Kyselyissä voi käyttää filttereitä. Yritä listata vain ne reseptit joiden
henkilömäärä on 4.
Yritä listata ne reseptit joiden henkilömäärä on suurempi tai yhtä suuri kuin 4.query.add_filter("henkilomaara", "=", 4) - Järjestä reseptilistaus nimen mukaan
Kaatuiko sovellus? Saitko virheilmoituksen, joka näyttää seuraavanlaiselta:query.order = ["nimi"]google.api_core.exceptions.FailedPrecondition google.api_core.exceptions.FailedPrecondition: 400 no matching index found. recommended index is: - kind: Resepti properties: - name: henkilomaara - name: nimi
Kaikki kyselyt edellyttävät, että datastoresta löytyy niihin sopiva indeksointi. Kyselyn ollessa tarpeeksi monimutkainen ei oletusindeksointi enää riitä. Täytyy luoda kyselyyn sopiva indeksi. Käytössä olevat yhdistetyt indeksit. Helpoin tapa luoda tarvittavat indeksi on käyttää datastore emulaattoria, joka luo indeksoinnit automaattisesti. Pääteohjaus kannattaa tehdä loppuun emulaattorilla. Kun koko tehtävä on valmis päivitä index.yaml tiedosto pilveen ja kokeile toimiiko sovellus myös pilvessä olevalla datastorella.gcloud datastore indexes create /polku/index.yaml-tiedostoon/index.yaml - Hae myös kaikki ruokalajit ja listaa ne myös samalla reseptisivulla
- Listaa reseptisivulla reseptien nimien yhteydessä myös sen ruokalajin nimi johon resepti kuuluu. Et pysty hakemaan näitä tietoja yhdellä kyselyllä, kuten relaatiotietokannan yhteydessä. Sinun pitää erikseen yhdistellä nämä tiedot. Esim. Lisää kaikki ruokalajit yhteen dictionaryyn, jossa käytät avaimena kunkin ruokalajin id:tä (ruokalaji.id. Key. Vastaava id on tallennettu myös jokaisen reseptin resepti.key.parent-ominaisuuteen.
- Luo WTForms-lomake ruokalajien editoimista varten. Yritä ensimmäisenä lisätä uusia ruokalajeja.
- Lisäämisen onnistuttua yritä tehdä lomakkeesta muokkauslomake. Tee ruokalajilistauksesta linkkejä joilla voit valita kulloinkin muokattavana olevan ruokalajin
- Yritä lisätä myös uusia reseptejä datastoreen.
- Tee reseptilistauksesta linkkilista, jolla voit valita jonkun resepteistä lomakkeelle muokattavaksi.
Käytä muotoa /reseptit/ruokalajinid/reseptinid-olevia linkkejä
- Vastaavasti muuta funktiosi route muotoon (Kts. Variable rules):
@app.route('/reseptit/<ruokalaji_id>/<resepti_id>', methods=['GET','POST']) def reseptit(ruokalaji_id, resepti_id): - Voit nyt helposti luoda lomakkeen, jolla on valmiiksi editoitavana valittu resepti:
Huom. edeltävä ei toimi, jos jostain syystä reseptien tai ruokalajien id:t eivät olekkaan numeraalisia vaan merkkijonoja. Kannattaa pitää tunnisteet aina saman tyyppisinä eikä sotkea eri tietotyyppejä.reseptikey = client.key("Ruokalaji", int(ruokalaji_id), "Resepti", int(resepti_id)) resepti = client.get( reseptikey ) formReseptit = Reseptit(data=resepti) - Reseptin varsinainen lisääminen kannattaa tehdä omassa funktiossaan, josta ohjataan lisäämisen jälkeen reseptisivulle. Jos lisääminen onnistuu niin siirrytään edelleenohjauksella (redirect), jos taas lomakkeessa on jotain vikaa niin tehdään normaali funktiokutsu. Edelleenohjatessa lomakkeelta lähetetyt tiedot (POST) eivät siirry mukana, mutta jos tehdään normaali funktiokutsu niin lomaketiedot ovat mukana. Muuta reseptilistaussivun lomake sellaiseksi, että se osaa listata virheilmoitukset.
- Mallisovellus (kesken) , Malliratkaisu (zip-paketti)
Käyttäjien kommentit